PDF-Epubber für Mac, meine Eigenentwicklung, um PDF-Dokumente möglichst mühelos und perfekt in ein Ebook-Reader-freundliches EPUB-Format umzuwandeln befindet sich seit dem 22. April 2026 in der Entwicklung. Das KI-Tool Codex (Chat GPT) programmiert, und ich gebe die Richtung vor.
Es gab schon einige Rückschläge, die dazu führten, dass ich immer wieder von vorne begonnen habe. Aktuell befindet sich eine eigene OCR-Engine in der Entwicklung. Denn die optischen Zeichenerkennung ist das Fundament auf dem die eigentliche EPUB-Konvertierung aufbaut.
Warum eine Eigenentwicklung?
Ich lese gerne Bücher auf einem Ebook-Reader. Nicht alle Bücher gibt es als Ebook zu kaufen. Um auch Papierbücher, die nicht als Ebook erhältlich sind, auf einem Ebook-Reader lesen zu können, muss es zunächst eingescannt, als PDF gespeichert und schließlich in ein EPUB-Format konvertiert werden.
Bis dato kenne ich keinen einzigen EPUB-Konverter, der diese Aufgabe zufriedenstellend löst. Von alle EPUB-Konvertern am Markt ist der ABBYY Finereader PDF der beste, aber lieder auch mit vielen Fehlern, die immer wieder auftauchen und eine Korrektur erfordern.
Mein Ziel war es also, einen EPUB-Konverter zu entwickeln, der die bekannten Schwächen der hiesigen EPUB-Konverter beseitigt.
Dabei rausgekommen ist der PDF-Epubber, den ich mit Codex (Chat GPT) entwickelt habe. Die Programmierung erledigte also Codex in Python, die Vorgaben und das Trainieren der KI erfolgte von mir.
Der Plan
Kostenlose & Spendenversion
Es wird eine kostenlose Version mit reduziertem Funktionsumfang sowie eine Spendenversion mit vollem Funktionsumfang geben.
Schon die kostenlose Version ist leistungsstark und bietet die vollständigen OCR- und EPUB-Konverter-Funktionalitäten und ist für die reine Konvertierung von PDF zu EPUB vollkommen ausreichend.
Wer mehr will, einschl. den EPUB-Ersetzungs-Regeln sowie fortgeschrittene Einstellungsmöglichkeiten, kann die Spendenversion kaufen. Dazu wird eine Lizenz zu einem Preis von vermutlich 15,00 Euro verkauft. Ein Abomodell wird es nicht geben und keine Kosten für Upgrades. Wer einmalig zahlt bekommt das volle Paket.
Veröffentlichung im Herbst 2026
Das Testen und Verbessern der App steht im Vordergrund. Eine Veröffentlichung wird erst dann erfolgen, wenn ich genug Erfahrungen mit verschiedensten Büchern gemacht habe.
Zudem muss ich mir darüber im Klaren sein, was es bedeutet, eine Software zu vertreiben, welcher Aufwand dahinter steckt. Dazu kommt natürlich Support und Betreuung. Das muss gut überlegt sein – auch von der rechtlichen Seite, was Copyright und Nutzungsrechte betrifft.
Daher gehe ich davon aus, dass eine Veröffentlichung nicht vor Herbst 2026 erfolgen wird.
Die Herausforderung
Die Konvertierung von PDF zu EPUB gilt unter den Dokumentenkonvertern als Köngisdisziplin. Es ist ein sehr komplexer Vorgang mit vielen Fallstricken und Problemen.
Um ein Papierbuch auf einen Ebook-Reader zu bringen, ist folgendes zu tun:
- Der Buchrücken wird abgeschnitten, sodass man die Einzelseiten des Buches hat.
- Mit einem Dokumentenscanner werden die Buchseiten eingescannt.
- Die eingescannten Seiten werden als PDF-Dokument abgespeichert.
- Das PDF muss durch ein Texterkennungsprogramm (OCR) geschleust werden.
- Dann kann das PDF mit integrierter Textebene (OCR) in das EPUB-Format konvertiert werden.
Texterkennung – OCR
OCR steht für Optical Character Recognition, also für optische Zeichenerkennung. Eine eingescannte Buchseite (Text) ist zunächst nichts anderes als ein Bild, ein Foto, wenn man so will. Dieses Bild muss nun in Text umgewandelt werden. Das macht eine sogenannte OCR-Engine – eine Texterkennungs-Maschine, eine Software.
An die OCR-Engine werden hohe Anforderungen gestellt. Sie muss in der Lage sein, aus den unzähligen Schriftarten sowie Sonderformen (z.B. Initiale, spezielle Formatierungen) die es gibt, die einzelnen Zeichen korrekt zu erkennen und in entsprechenden Text umzuwandeln.
Beim Einscannen eines Buches wird nicht nur der Text eingescannt, sondern auch Staub und Flecken. Die OCR-Engine muss erkennen, was ist Text, was ist Dreck.
Bevor also der eigentliche EPUB-Konverter ins Spiel kommt, muss das PDF mit einer Textebene ausgestattet werden, was die OCR-Engine erledigt.
Tungsten liefert sehr gute OCR-Ergebnisse
Eine sehr gute OCR-Engine ist die, die beim Kauf eines EPSON-Scanners mit dabei ist; und die stammt von der Firma Tungsten. Damit kann man sehr gute Ergebnisse erzielen.
Da ich mit einem EPSON DS-410-Scanner arbeite, habe ich bereits die OCR-Engine mit an Board.
Kodak Capture Pro
Die Bücher, die ich bei einem Reporservice habe digitalisieren lassen, wurden mit einem professionellen Scanner von Kodak unter Verwendung der Software Kodak Capture Pro gescannt. Und das stellt alles in den Schatten, was ich bisher an OCR-Ergebnissen gesehen habe. Die Scans sind von sehr hoher Qualität und die Texterkennung ist perfekt. So ein Scanner von Kodak kostet um die 9.000 Euro (Kodak i4250).
PDF-Epubber mit integrierter OCR-Engine
Der PDF-Epubber erkennt, ob ein PDF bereits eine Textebene hat. Falls das der Fall ist, fragt die App, ob die vorhandene Textebene für die Konvertierung ins EPUB-Format verwendet werden soll oder ob man einen neuen OCR-Lauf durchführen möchte.
Die in der App eingebaute OCR-Engine basiert auf Tesseract und OCRmyPDF – beides OpenSource-Projekte.
Da Tesseract schlechter arbeitet als EPSON-OCR, war mein Ziel, die OCR-Ergebnisse von Tesseract weiter zu verbessern.
EPSON-OCR ist sozusagen die Messlatte.
EPUB-Konvertierung
Wenn es also ein PDF mit integrierter Textebene gibt, ist der nächste Schritt diesen Text in ein gut strukturiertes und gut lesbares EPUB-Format umzuwandeln – das ist, was der PDF-Epubber macht. Er analysiert nicht nur den reinen Text sondern auch das PDF und schaut nach Formatierungen (kursiv und fett), um diese ebenfalls im EPUB-Format abzubilden.
Weiterhin wird die Buchstruktur erkannt und entsprechend konvertiert. Dazu zählen u.a.:
- Titel und Autor
- Impressum
- Danksagung
- Widmung
- Zitate
- Klappentext
- Kapitel
- etc.
Der EPUB-Konverter versucht zudem OCR-Fehler zu erkennen und zu korrigieren.
Die Entwicklung
Da ich selbst kein Programmierer bin, habe ich mich nach einer KI umgeschaut ist, die in der Lage ist, zu programmieren. Das können heute inzwischen die meisten KI’s (Google Gemini, Microsoft Copilot, Codex von ChatGPT oder Claude)
Ich habe mich für Codex entschieden. Denn bei Codex kann man einen Ordner auf der Festplatte freischalten, sodass Codex den Code sofort direkt auf dem Computer speichert. Das erleichtert die Zusammenarbeit enorm.
Man formuliert an Codex, was man sich vorstellt, und Codex setzt das programmiertechnisch um. Das klingt einfacher als es ist. Es ist ein sehr langwieriger Prozess, der viel Geduld erfordert. Denn Codex ist nicht perfekt, macht Fehler, verheddert sich, vergisst Dinge….ja, es ist eine KI mit menschlichen Zügen. Ich hätte nicht gedacht, dass eine KI so viele Fehler machen kann. Das hat teilweise für viel Frust gesorgt.
Man muss lernen, mit der KI zusammen zu arbeiten, wie man mit ihr spricht, wie man sie motiviert und dazu bewegt, das zu tun, was man im Sinn hat.
Man selbst braucht sehr klare Vorstellungen, was man will, wie die Software arbeiten und wie sie strukturiert sein soll.
Es kostet nicht nur Zeit, sondern auch Abogebühren. Ich habe für die Entwicklung ein Monatsabo, dass ca. 100 Euro kostet. Ansonsten ist man so beschränkt, dass man ständig den Hinweis bekommt, man müsse upgraden, um Codex weiter nutzen zu können.
Der aktuelle Stand
Heute ist der 04.Mai 2026. Angefangen mit der App habe ich am 22.April 2026. Die Programmierung der App erfolgt ausschließlich über Codex (Chat GPT). Heute habe ich wieder einmal, „erneut“ angefangen, d.h. einen komplett neuen Weg eingeschlagen. Schon mehrfach musste ich die Richtung ändern, weil das Programm nicht so arbeitet, wie ich es mir vorstelle und weil ich feststellen musste, dass der eingeschlagene Weg der falsche ist.
Tesseract macht zu viele Fehler
Jetzt bin ich davon überzeugt, den richtigen Weg zu gehen. Ich habe nämlich festgestellt, dass die OCR-Engine Tesseract semantische Fehler (z.B. verliefen statt verließen) macht, die sich über die App nicht so ohne weiteres korrigieren lassen. Denn beide Wörter sind real existierende Wörter. Die App kann nicht wissen, dass das falsch ist. Andes ist es, wenn die OCR anstatt auf das falsche Wort aut schreibt. Das kann man korrigieren, weil es das Wort im deutschen nicht gibt.
Apple Vision als OCR-Engine
Da ich die App sowieso für macOS entwickle, kann ich auch die im macOS existierende Texterkennung auf Basis von „Apple Vision“ nutzen. Die ist zuverlässiger als Tesseract und ebenso kostenlos.
Warum nicht Epson nutzen?
Ja, ich scanne meine Bücher mit einem EPSON-Scanner ein und habe damit auch eine sehr gute Textebene im PDF drin. Der PDF-Epubber ist so entwickelt, dass er bereits bestehende Textebenen erkennt und diese für die Konvertierung ins EPUB-Format nutzen kann.
ABER: Meine App soll so entwickelt werden, dass ich davon ausgehe, dass nicht jeder eine so gute OCR-Engine für die Digitalisierung von Büchern zur Verfügung hat wie ich mit der Epson-Software. Meine App soll eine eingebaute OCR-Engine haben, die sehr gut arbeitet und Text zuverlässig und möglichst fehlerfrei erkennt. Ich möchte neue Maßstäbe setzen mit meiner App. Daher gehe ich den unbequemen Weg mit eigenem OCR und eigener OCR-Korrektur.
Eigenes OCR
Inzwischen bin ich soweit, dass ich ein eigenes OCR entwickle bzw. entwickeln lasse. Apple Vision versagt grandios und TesserAct macht zu viele semantische Fehler, die so ohne weiteres nicht korrigierbar sind. Also dachte ich mir: Warum nicht ein eigenes OCR entwickeln. Der Anfang ist gemacht.
Steiniger Weg
Der Anfang der Entwicklung war ein böses Kauderwelsch. Hier mal gezeigt, was das OCR aus dem Buch gelesen hat.
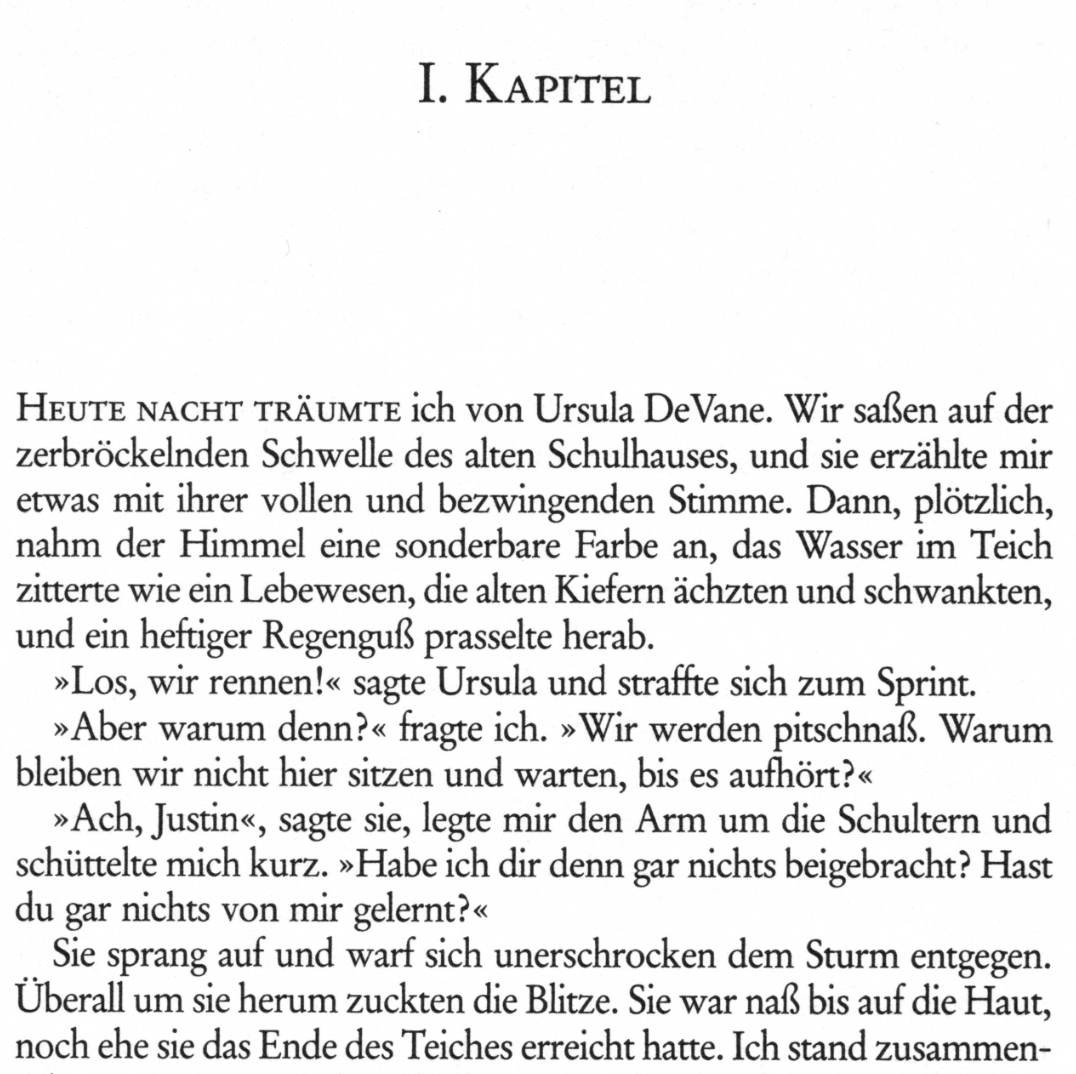
;;;1. KAMTEL
HEUTE NACHT T“UMTE iA von U"“ DdWm. Wk “en “J“
ze““kUMen SAwue A8 J. SAuEm”8. .J sie e“mK mL
“Was mk m“r WÜen und b“Mn.Men Sdm-. Dann. NNAA.
nAm der Mmmd “e s0Mema” nme an. “8 v“8er “ n“
”mm Me “ LeM.sen` Te d. M´rn Kh”m uM 8A-A-.
unATLOZ””“8iAzumSonnt. ;
»Ab“warumdenni«MBmiA.»Wk-mmomAn“.`mn1 ;
N“enwkm“m“8i“enundw“mn`Me8”mön?« ;
»Am’N8“«’sa´8ie,le´nAdmA-u1n“SAu"m.d ;
sAümke“A“rz.»HAeiA“denn.r““hd.bm“?fLn l
“.rmA"Vonmk“enR)« l
zm:::CUTZmwnLZ7m; ;
noAAesie“sFnAde8n“es.O“M“.“mMzu8ammen- l
….und nach ein paar Stunden Training kann man den Text schon lesen…
I. KAPITEL
HEUTE NACHT TRÄUMTE ich von Ursula DeVane. Wir saßen auf der
zerbröckelnden Schwelle des alten Schulhauses, und sie erzählte mir
etwas mit ihrer vollen und bezwingenden Stimme. Dann, plötzlich,
nahm der Himmel eine sonderbare Farbe an, das Wasser im Teich
zitterte wie ein Lebewesen, die alten Kiefern ächzten und schwankten,
und ein heftiger Regenguß prasselte herab.
»Los, wir rennen!« sagte Ursula und straffte sich zum Sprint.
»Aber warum denn?« fragte ich. »Wir werden pitschnaß. Warum
bleiben wir nicht hier sitzen und warten, bis es aufhört?«
»Ach, Justin«, sagte sie, legte mir den Arm um die Schultern und
schüttelte mich kurz. »Habe ich dir denn gar nichts beigebracht? Hast
du gar nichts von mir gelernt?«
Sie sprang auf und warf sich unerschrocken dem Sturm entgegen.
Überall um sie herum zuckten die Blitze. Sie war naß bis auf die Haut,
noch ehe sie das Ende des Teiches erreicht hatte. Ich stand zusammen-
Testen, testen, testen
Also bin ich am testen, analysieren, ausprobieren. Immer wieder werden neue Bücher gescannt, mit der App konvertiert, das Ergebnis analysiert und der Code weiter verbessert. Das ist ein langwieriger Prozess – und daher rechne ich damit, dass die App nicht vor Herbst 2026 veröffentlicht wird.
Mein Ziel
Ich möchte eine Software anbieten, die es jedem ermöglicht, eingescannte Bücher möglichst perfekt ins EPUB-Format umzuwandeln. Perfekt ist sicher nicht möglich. Ich kenne bis dato keine Software, die das wirklich perfekt macht. Aber es ist mein Anspruch, es so gut wie nur irgendmöglich zu machen – besser als das, was der ABBYY FineReader PDF aktuell liefert.